Öffentlich im Internet zugänglich heißt nicht frei nutzbar
Was ist beim KI-Training mit personenbezogenen Daten erlaubt?
Texte, Bilder, Bewertungen, berufliche Profile und öffentliche Beiträge sind im Internet leicht zugänglich. Für die Entwicklung von KI-Systemen können solche Informationen besonders interessant sein.
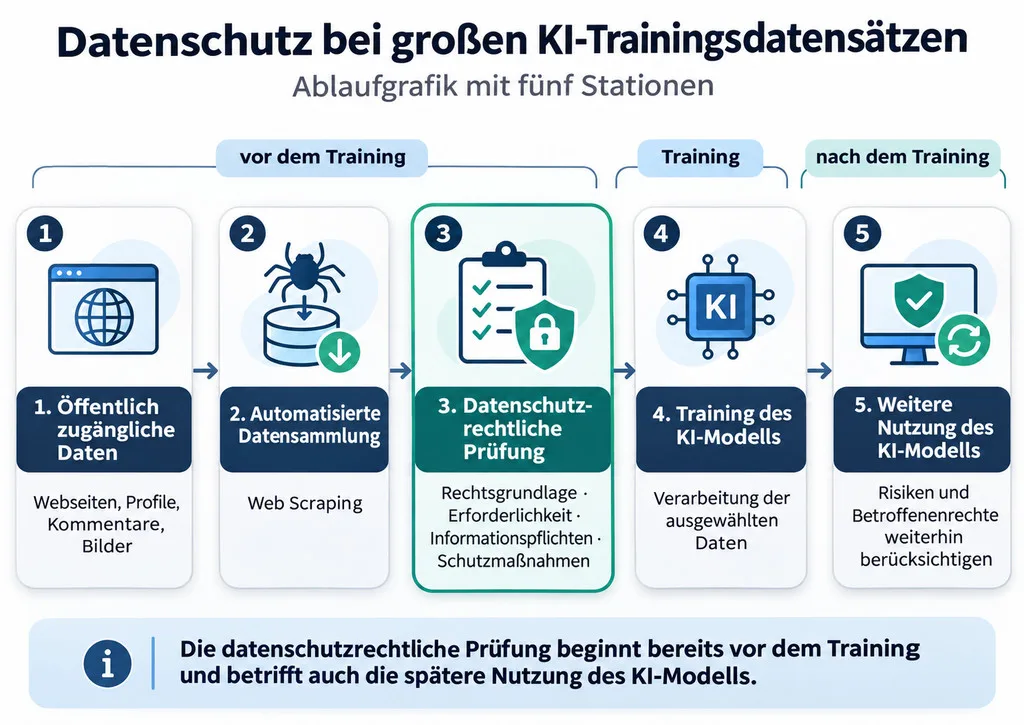
Mit automatisierten Verfahren lassen sich große Datenmengen erfassen und anschließend beispielsweise für das Training oder die Verbesserung von KI-Modellen verwenden. Dabei wird jedoch häufig ein wichtiger Punkt übersehen: Öffentlich zugänglich bedeutet nicht automatisch frei verwendbar.
Wenn die gesammelten Informationen einen Bezug zu identifizierten oder identifizierbaren Personen haben, handelt es sich um personenbezogene Daten. Für ihre Verarbeitung gilt grundsätzlich die Datenschutz-Grundverordnung. Das gilt auch dann, wenn die Informationen ohne Anmeldung auf einer Webseite abrufbar sind.
Was ist Web Scraping und warum wird es für KI eingesetzt?
Beim sogenannten Web Scraping werden Informationen automatisiert von Webseiten ausgelesen. Statt einzelne Inhalte manuell zu kopieren, können Programme große Mengen an Informationen erfassen und für eine spätere Verarbeitung zusammenstellen.
Bei der Entwicklung von KI-Systemen kann Web Scraping beispielsweise dazu dienen, umfangreiche Textsammlungen aufzubauen oder bestehende Datensätze zu ergänzen. Dabei können neben allgemeinen Informationen auch personenbezogene Daten erfasst werden, etwa Namen, Fotos, Kontaktdaten, berufliche Angaben oder öffentliche Kommentare.
Nicht jedes Web Scraping fällt deshalb automatisch unter die DSGVO. Werden ausschließlich Informationen ohne Personenbezug verarbeitet, ist die DSGVO insoweit nicht einschlägig. Sobald personenbezogene Daten betroffen sind, muss jedoch geprüft werden, ob und unter welchen Voraussetzungen die Verarbeitung zulässig ist.
Eine öffentliche Veröffentlichung ist keine allgemeine Einwilligung
Ein berufliches Profil wird veröffentlicht, damit andere Personen Informationen über eine berufliche Tätigkeit finden können. Eine Bewertung soll anderen Nutzern bei einer Kaufentscheidung helfen. Ein Kommentar dient der Beteiligung an einer Diskussion.
Daraus folgt nicht automatisch, dass die betroffenen Personen auch mit der Verwendung ihrer Angaben für das Training eines KI-Modells rechnen. Gerade dieser Zusammenhang ist für die datenschutzrechtliche Bewertung wichtig.
Der Europäische Datenschutzausschuss weist in seiner Stellungnahme 28/2024 zu KI-Modellen darauf hin, dass bei der Bewertung berechtigter Interessen auch die vernünftigen Erwartungen der betroffenen Personen zu berücksichtigen sind. Dabei kann unter anderem relevant sein, ob Daten öffentlich zugänglich waren, aus welcher Quelle sie stammen und in welchem Zusammenhang sie ursprünglich veröffentlicht wurden.
Eine öffentliche Veröffentlichung kann also ein relevanter Umstand sein. Sie ersetzt aber keine datenschutzrechtliche Prüfung.
Welche Rechtsgrundlage kommt für das KI-Training infrage?
Wer personenbezogene Daten für die Entwicklung oder das Training eines KI-Modells verwendet, benötigt eine geeignete Rechtsgrundlage nach Art. 6 DSGVO.
Eine Einwilligung ist dabei nicht in jedem Fall zwingend erforderlich. Je nach Verarbeitung kann beispielsweise ein berechtigtes Interesse nach Art. 6 Abs. 1 lit. f DSGVO in Betracht kommen. Allerdings reicht es nicht aus, sich pauschal auf das Interesse an der Entwicklung einer leistungsfähigen KI zu berufen.
Berechtigte Interessen müssen sorgfältig geprüft werden
Bei einer Verarbeitung auf Grundlage berechtigter Interessen müssen insbesondere drei Fragen beantwortet werden:
Der Europäische Datenschutzausschuss erläutert diese Prüfung ausdrücklich auch für die Entwicklung und Nutzung von KI-Modellen. Dabei spielen beispielsweise die Art der Daten, der ursprüngliche Veröffentlichungskontext, die Erwartungen der Betroffenen und mögliche Auswirkungen der Verarbeitung eine Rolle. Die Bewertung muss deshalb auf die konkrete Verarbeitung zugeschnitten sein.
Besonders sensible Daten sind gesondert zu betrachten
Noch strengere Anforderungen gelten für besondere Kategorien personenbezogener Daten. Dazu gehören beispielsweise Gesundheitsdaten, Informationen über politische Meinungen, religiöse Überzeugungen oder die sexuelle Orientierung. Solche Informationen können auch in öffentlich zugänglichen Beiträgen enthalten sein.
Für ihre Verarbeitung ist neben einer Rechtsgrundlage nach Art. 6 DSGVO grundsätzlich eine Ausnahme nach Art. 9 Abs. 2 DSGVO erforderlich. Eine mögliche Ausnahme betrifft Daten, die die betroffene Person offensichtlich öffentlich gemacht hat. Allerdings bedeutet die bloße Auffindbarkeit einer Information im Internet nicht automatisch, dass diese Voraussetzung erfüllt ist. Unternehmen sollten deshalb besonders sorgfältig prüfen, ob solche Informationen überhaupt benötigt werden und wie eine unbeabsichtigte Erfassung vermieden werden kann.
Müssen betroffene Personen über das Web Scraping informiert werden?
Neben der Rechtsgrundlage gibt es eine weitere Herausforderung: die Transparenz. Werden personenbezogene Daten nicht direkt bei der betroffenen Person erhoben, gelten grundsätzlich die Informationspflichten nach Art. 14 DSGVO. Das ist beim Web Scraping häufig der Fall.
Betroffene Personen müssen beispielsweise darüber informiert werden, wer ihre Daten verarbeitet, für welche Zwecke dies geschieht, welche Datenkategorien betroffen sind und woher die Informationen stammen.
Grundsätzlich müssen diese Informationen innerhalb einer angemessenen Frist, spätestens jedoch innerhalb eines Monats nach Erlangung der Daten bereitgestellt werden. Abhängig von der weiteren Verwendung können auch frühere Zeitpunkte maßgeblich sein.
Bei großen KI-Trainingsdatensätzen kann das schwierig werden. Häufig sind sehr viele Personen betroffen, deren Kontaktdaten nicht vorliegen oder deren Identität nicht ohne Weiteres festgestellt werden kann. Die praktische Schwierigkeit allein lässt die Informationspflicht jedoch nicht automatisch entfallen.
Gibt es Ausnahmen von der Informationspflicht?
Art. 14 Abs. 5 DSGVO sieht bestimmte Ausnahmen vor. Eine davon kann greifen, wenn sich die individuelle Information als unmöglich erweist oder einen unverhältnismäßigen Aufwand erfordern würde. Das bedeutet allerdings nicht, dass bei großen Datensammlungen grundsätzlich auf Informationen verzichtet werden darf.
Ob eine Ausnahme tatsächlich vorliegt, muss anhand der konkreten Umstände geprüft werden. Dabei können beispielsweise die Anzahl der betroffenen Personen, die verfügbaren Kontaktmöglichkeiten, der Aufwand einer individuellen Information und die Auswirkungen auf die betroffenen Personen eine Rolle spielen.
Wird die Ausnahme wegen Unmöglichkeit oder unverhältnismäßigen Aufwands nach Art. 14 Abs. 5 lit. b DSGVO genutzt, muss der Verantwortliche geeignete Maßnahmen zum Schutz der Rechte und Freiheiten der betroffenen Personen treffen. Dazu gehört ausdrücklich auch, die Informationen öffentlich verfügbar zu machen.
Eine transparente Datenschutzinformation kann daher ein wichtiger Bestandteil solcher Maßnahmen sein. Sie ist aber kein pauschaler Ersatz für eine individuelle Information, wenn die Voraussetzungen der gesetzlichen Ausnahme nicht erfüllt sind. Art. 14 DSGVO im vollständigen Gesetzestext
Welche Risiken entstehen durch große KI-Trainingsdatensätze?
Bei der Sammlung großer Datenmengen können Informationen zusammengeführt werden, die ursprünglich in ganz unterschiedlichen Zusammenhängen veröffentlicht wurden.
Ein einzelner öffentlicher Beitrag mag für sich genommen wenig über eine Person aussagen. Werden zahlreiche Informationen miteinander verknüpft, können daraus umfangreiche Personenprofile entstehen.
Hinzu kommt, dass KI-Modelle unter bestimmten Umständen Informationen aus Trainingsdaten wiedergeben oder Rückschlüsse auf einzelne Personen ermöglichen können.
Der Europäische Datenschutzausschuss betont deshalb, dass ein KI-Modell nicht automatisch als anonym angesehen werden darf. Ob tatsächlich eine Anonymisierung vorliegt, muss anhand der konkreten Umstände bewertet werden.
Unternehmen sollten sich deshalb nicht allein darauf verlassen, dass personenbezogene Daten nach dem Training nicht mehr unmittelbar als einzelne Datensätze sichtbar sind. Auch die weitere Verarbeitung und mögliche Offenlegung personenbezogener Informationen durch das KI-Modell müssen berücksichtigt werden.
Was sollten Unternehmen vor der Verwendung solcher Daten prüfen?
Nicht jedes Unternehmen entwickelt eigene KI-Modelle. Wer jedoch öffentlich zugängliche Informationen für KI-Projekte sammelt, bestehende Modelle mit zusätzlichen Daten trainiert oder entsprechende Datensätze von Dritten bezieht, sollte die Herkunft und Zulässigkeit der Datenverarbeitung prüfen. Dabei helfen insbesondere folgende Fragen:
Bei umfangreichen oder besonders risikoreichen Verarbeitungen sollte außerdem geprüft werden, ob eine Datenschutz-Folgenabschätzung nach Art. 35 DSGVO erforderlich ist. Die Prüfung sollte vor Beginn der Datensammlung und nicht erst nach dem Training erfolgen.
Auch beim Bezug fertiger KI-Systeme lohnt sich ein Blick auf die Datenherkunft
Unternehmen müssen nicht selbst Web Scraping betreiben, um mit dem Thema in Berührung zu kommen. Auch beim Einsatz externer KI-Anwendungen kann relevant sein, welche Daten für die Entwicklung oder Anpassung des Modells verwendet wurden. Allerdings haben Unternehmen, die ein fertiges KI-System einsetzen, nicht zwangsläufig denselben Einblick oder dieselbe datenschutzrechtliche Verantwortung wie der Entwickler.
Deshalb sollten zunächst die Rollen und tatsächlichen Datenverarbeitungen geklärt werden. Sinnvolle Fragen an den Anbieter können beispielsweise sein, ob personenbezogene Daten für das Training verwendet wurden, welche Informationen zur Datenherkunft vorliegen und welche Schutzmaßnahmen vorgesehen sind. Welche Nachweise und vertraglichen Regelungen erforderlich sind, hängt vom konkreten Einsatz und der datenschutzrechtlichen Rollenverteilung ab.
Podsumowanie
Öffentlich zugängliche personenbezogene Daten dürfen nicht automatisch für das Training von KI-Modellen verwendet werden. Auch beim Web Scraping müssen Unternehmen prüfen, ob eine geeignete Rechtsgrundlage besteht, welche Daten tatsächlich benötigt werden und welche Risiken für betroffene Personen entstehen.
Besonders wichtig sind außerdem die Informationspflichten. Dass eine große Anzahl von Personen betroffen ist, rechtfertigt nicht automatisch den Verzicht auf eine individuelle Information. Entscheidend ist nicht allein, ob Daten technisch zugänglich sind, sondern ob ihre Verwendung für den konkreten Zweck datenschutzrechtlich zulässig ist.
FAQ
Dürfen öffentlich zugängliche personenbezogene Daten für KI-Training verwendet werden?
Das kann zulässig sein, ist aber nicht automatisch erlaubt. Auch bei öffentlich zugänglichen personenbezogenen Daten müssen die Anforderungen der DSGVO erfüllt werden.
Was bedeutet Web Scraping?
Beim Web Scraping werden Informationen automatisiert von Webseiten ausgelesen und gesammelt. Die gewonnenen Daten können anschließend beispielsweise ausgewertet oder für die Entwicklung von KI-Systemen verwendet werden.
Braucht man für das KI-Training immer eine Einwilligung?
Nein. Je nach Verarbeitung kann auch eine andere Rechtsgrundlage infrage kommen, beispielsweise ein berechtigtes Interesse nach Art. 6 Abs. 1 lit. f DSGVO. Ob dieses tatsächlich trägt, muss im Einzelfall geprüft werden.
Müssen betroffene Personen über das Sammeln ihrer Daten informiert werden?
Grundsätzlich ja. Werden personenbezogene Daten nicht direkt bei der betroffenen Person erhoben, gelten regelmäßig die Informationspflichten nach Art. 14 DSGVO. Unter bestimmten Voraussetzungen sind Ausnahmen möglich.
Darf ein Unternehmen Gesundheitsdaten oder andere sensible Informationen aus dem Internet für KI verwenden?
Hier gelten zusätzliche Anforderungen. Für besondere Kategorien personenbezogener Daten nach Art. 9 DSGVO ist neben einer Rechtsgrundlage nach Art. 6 auch eine Ausnahme nach Art. 9 Abs. 2 DSGVO erforderlich.
Was sollten Unternehmen vor der Verwendung öffentlich zugänglicher Daten prüfen?
Wichtig sind insbesondere die Herkunft der Daten, der Verwendungszweck, die Rechtsgrundlage, die Erforderlichkeit, mögliche Risiken für betroffene Personen sowie die Informationspflichten und Möglichkeiten zur Wahrnehmung von Betroffenenrechten.